- NO.
- 047
- DATE
- READ
- ~8 min
- KIND
- 笔记
- STATUS
- 原文
Pi 接入 MCP:读文件成功,权限却比预期大
在 WSL 的 Pi 中接入文件系统 MCP,记录真实工具调用、Roots 覆盖目录参数的复核,以及商业 SEO MCP 的权限和计费边界。
这次想弄清楚 MCP(Model Context Protocol)在 Coding Agent 里是怎么工作的,没有从 Semrush 或 DataForSEO 这类商业数据服务开始,而是选了一个最容易核对的实验:让 Pi 通过文件系统 MCP 读取一行中文。
文件读出来了。但后来检查目录权限时,发现一个比“连接成功”更值得记录的问题:启动参数只指定了 files 子目录,服务实际允许访问的却是上一级项目目录。
本文以当时的实验记录为依据,复盘配置、工具调用和只读权限对照。商业 SEO MCP 部分来自截至 2026 年 10 月 21 日的官方文档,没有实际发起付费 API 请求。
为什么要绕一圈 MCP 读文件
Pi 本来就能通过内置 read 和 bash 访问本地文件。只要目标是读取一个文本文件,直接用内置工具更简单。
这次用 MCP,是为了验证另一条调用链:
用户 → Pi → 模型
        ↓   ↑
      MCP Client
        ↕
      文件系统 MCP Server
        ↕
      WSL Ubuntu 文件
Pi 是管理会话和工具的宿主应用;文件系统 MCP Server 是另一个进程,负责真正执行文件操作。模型根据工具定义提出调用,结果经 Pi 返回给模型,再生成回答。
本次使用的是 stdio 传输:Pi 启动本地子进程,通过标准输入、标准输出交换 JSON-RPC 消息,不需要为它开放网络端口。但本地执行不代表文件内容一定留在本地:工具返回的文本通常还会进入当前模型服务的上下文。
最小实验:配置之外,还要看到工具调用
实验环境是 Windows 11 的 WSL Ubuntu。记录中的版本为 Node.js v24.18.0、npx 11.16.0、Pi 1.1.0;当时缓存的文件系统服务包为 2.0.0。这些是本次实验的版本,不是所有环境必须使用的固定组合。
先创建独立目录和一行测试文本:
mkdir ~/mcp-demo &&
cd ~/mcp-demo &&
mkdir files &&
printf '%s\n' '你好,这是我的第一个 MCP 测试文件。' > files/hello.txt
然后在该目录登记项目级 MCP 连接:
pi mcp add filesystem --local --exposure direct -- \
  npx -y @modelcontextprotocol/server-filesystem "$HOME/mcp-demo/files"
--local 的意思是将连接信息写进项目内的 .pi/mcp.json,不是说 MCP 只能访问本地资源;--exposure direct 则让连接中的工具直接提供给模型。这里的 npx -y 还可能自动下载软件包,不应把它理解成对后续所有工具操作的授权。
首次加载项目配置时,Pi 提示项目尚未被信任。确认这是自己创建的练习目录后,允许加载配置,再进入 Pi 使用 /mcp 检查连接。实验记录显示:
filesystem · connected · 14 tools · direct · project这一步证明服务连接成功,并且公开了 14 个工具,却不能证明目标文件已被读取。服务提供的工具还包括写入、编辑和移动文件,因此这不是一条只读连接。
为了排除 Pi 内置工具的干扰,测试时明确指定使用 mcp__filesystem__read_text_file,不能改用 read 或 bash。在实际调用记录中,出现的是:
filesystem/read_text_file
path="/home/<用户名>/mcp-demo/files/hello.txt"
其中用户名已匿名化。工具返回:
你好,这是我的第一个 MCP 测试文件。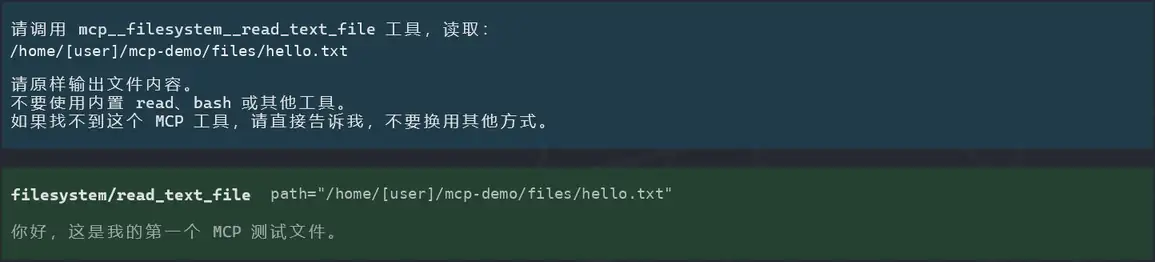
调用截图:工具名、参数与返回文本均来自实验记录,公开路径已匿名化。
确认成功的依据是工具名、调用参数与返回值三者能够对上,而不只是聊天窗口里出现了正确的一行文字。上面的调用记录是按实验材料转写的关键字段,不是协议报文抓包。
配置写的是 files,为什么实际范围变大了
原先传给文件系统服务的目录是:
/home/<用户名>/mcp-demo/files按这条参数直觉判断,服务似乎只能访问 files。但随后的只读复核,使用相同版本组合下的 Pi 客户端库,对比了提供和不提供客户端 Roots 的两种情况:
| 复核条件 | 服务实际允许的目录 |
|---|---|
| 客户端提供与 Pi 相同的 Roots | ~/mcp-demo |
| 不提供客户端 Roots | ~/mcp-demo/files |
复核还检查了 .pi/mcp.json 的文件元数据:第一种情况允许访问,第二种被拒绝;两种情况下,项目目录外的测试路径均被拒绝。这说明范围扩大到了项目目录,而不是整个家目录。
原因在于这次使用的旧协议连接。文件系统服务官方 README 说明:对于支持 Roots 的 2025 年版协议客户端,客户端提供的 Roots 可以替换服务从启动参数获取的允许目录。Pi 当时提供的是项目工作目录,因此服务最终采用了更大的范围。
这里还有一处版本边界:MCP 2026-07-28 已将 Roots 标为弃用,但并不意味着旧连接立刻无法使用;文件系统服务在新版协议连接下也采用不同的目录控制路径。所以这次观察不能推广成“所有 MCP 都会忽略启动参数”。
如果下次在真实项目中配置文件系统 MCP,我会先做三件事:
- 调用
list_allowed_directories,查看服务实际认为哪些目录可以访问。 - 在不修改文件的前提下,检查一个预期允许的路径和一个预期拒绝的路径。
- 如涉及真实敏感资料,使用单独用户、操作系统权限或只读挂载进一步隔离,而不只依赖工具描述和提示词。
尤其要注意:要求模型“只读取”,不是把含写入能力的工具变成了只读工具;服务层的路径限制,也不是对运行该进程的操作系统账户进行沙盒隔离。
限流报错与 MCP 故障不是一回事
实验中还出现过 exceeded token rate limit,随后切换到 deepseek-flash 才完成工具调用。
这条报错来自模型服务的 token 速率或配额限制,不能据此认定文件系统 MCP 连接失败。排查时可以按层区分:项目不受信任,先查配置加载;/mcp 连接失败,查服务进程与通信;工具返回 Access denied,查路径权限;模型报 token rate limit,则查模型侧限额和上下文。
direct 模式会把工具定义提供给模型,存在一定上下文开销。但仅凭这次截图,无法证明“14 个工具造成了限流”。这两件事没有做过控制变量的对照测试。
换成 Semrush、DataForSEO,真正变化的是什么
MCP 的共同作用是让模型发现并调用外部能力。不同服务之间更有意义的差别,是它们连接到什么数据、提供哪些操作,以及谁承担权限和费用。
| 本次文件系统 MCP | Semrush MCP | DataForSEO MCP | |
|---|---|---|---|
| 数据从哪来 | 指定目录里的已有文件 | Semrush 报告与项目数据 | DataForSEO 的各类 API |
| 主要调用方式 | 直接操作文件 | 发现报告、获取参数结构、执行报告 | 查文档、调用通用 API 请求工具 |
| 主要风险 | 文件访问与写入权限 | 账户权限、API units 消耗 | API 任务量、请求参数与余额 |
| 本次是否实测 | 已验证文件读取,记录了权限对照 | 未调用 | 未调用 |
Semrush 官方 MCP 使用远程 Streamable HTTP,支持 OAuth 或 API Key;当前文档把 Projects API v3 的 MCP 操作限定为只读。使用 MCP 本身不另收一笔 MCP 服务费,但相关报告仍按 API units 消耗额度,且具体访问资格依赖套餐。
DataForSEO 新版服务的核心工具只有 docs_index、docs_list_sections、docs_search 和 api_request 四个。它没有把几十种业务端点都直接摆成同级工具,而是让 Agent 先查文档,再构造请求。本地 stdio 和远程 HTTP 都可以使用;即使 MCP 在本地运行,业务请求仍可能访问远程付费 API。
DataForSEO 当前采用按量付费。官方列有新账户 1 美元试用额度及 Sandbox,最低充值金额为 50 美元。50 美元是充值门槛,不是一次 MCP 调用的费用;实际费用应按所选端点、模式和参数核算。
这也解释了为什么不能用工具数比较业务能力:本次文件系统 MCP 有 14 个工具,而 DataForSEO 的四个通用工具背后覆盖大量 API。接口数量与底层数据覆盖完全不是同一个指标。
真要用于 SEO 工作,先决定是否需要 MCP
如果只是分析已经导出的 GSC、关键词 CSV 或 Site Audit 报表,先用文件读取和现有分析脚本,不需要为了使用 MCP 而再接一层。任务固定、参数明确、需要批量重复执行时,直接 API 脚本通常更容易测试和估算费用。
MCP 更适合交互过程中需要动态选择工具,或者希望在多个兼容 AI 客户端之间复用同一套服务的情况。
至于商业 SEO 数据,我会把费用控制放在连接之前:
- 默认不允许 Agent 自行调用新的付费端点;首次放行前确认端点、单价、任务数和预期上限。
- 能用 Sandbox 或不计费的文档工具验证调用流程,就先不碰真实数据请求。
- 在服务商账户侧设置可用的消费限制,关闭不需要的自动充值;必要时用网关限制允许的端点和参数。
- 限制任务数、返回行数、分页、并发和重试。一次自然语言提问可能触发多次工具调用,甚至一个工具调用也可能提交多个计费任务。
- 对超时请求保留任务 ID 与消费记录,不在无法确认是否已计费时无限重试。
这些措施中,提示词只能约束 Agent 的行为倾向,不能当作可靠的费用硬上限。只读不代表免费,限速也不等于限额。
边界
这次真正验证的是:在记录所示版本的 WSL、Pi 与文件系统服务组合中,模型经 MCP 工具成功读取了测试文本;原复盘还留有 Roots 影响允许目录的只读对照结果。本轮撰稿没有重新连接该电脑,也没有运行 Semrush 或 DataForSEO 的业务 API。
没有验证的内容包括:其他 Pi 版本是否具有相同 Roots 行为、文件系统服务的生产环境安全性、两家商业 MCP 的实际稳定性和账单消耗。
如果以后继续接入新的 MCP,我会先看真实工具调用和实际授权范围,再决定开放哪些数据和能力。连接状态变绿只是第一步。
写作说明:GPT-6 根据实验记录和资料起草;作者提供截图并确认发布。
评论
评论由 GitHub Discussions 提供。登录 GitHub 后即可评论。 前往对应 Discussion