- NO.
- 039
- DATE
- READ
- ~7 min
- KIND
- 笔记
- STATUS
- 原文
同一份任务书,Opus 4.6 与 5.5 各写一篇 GEO 长文
同一份任务书分别交给 Claude Opus 4.6 和 Opus 5.5 写 GEO 长文。这里是原始资料、调用过程、长度用时与费用,以及 AI 逐条核对出的事实问题;评判留给读者。
2026-10-09,同一份中文写作任务书分别交给 Claude Opus 4.6 和 Claude Opus 5.5,各写一篇讲 GEO(Generative Engine Optimization,面向生成式答案引擎的内容优化)的长文。两篇原始输出并排放在对照阅读页,正文一字未改;任务书、参考报告和两次调用的原始返回打包在资料库。这篇记录过程和数据,附上 AI 做的核对与评语。每个模型只跑了一次,哪篇写得好,留给读者判断:对照阅读页底部可以投票,选更愿意读哪一篇,并勾选原因。
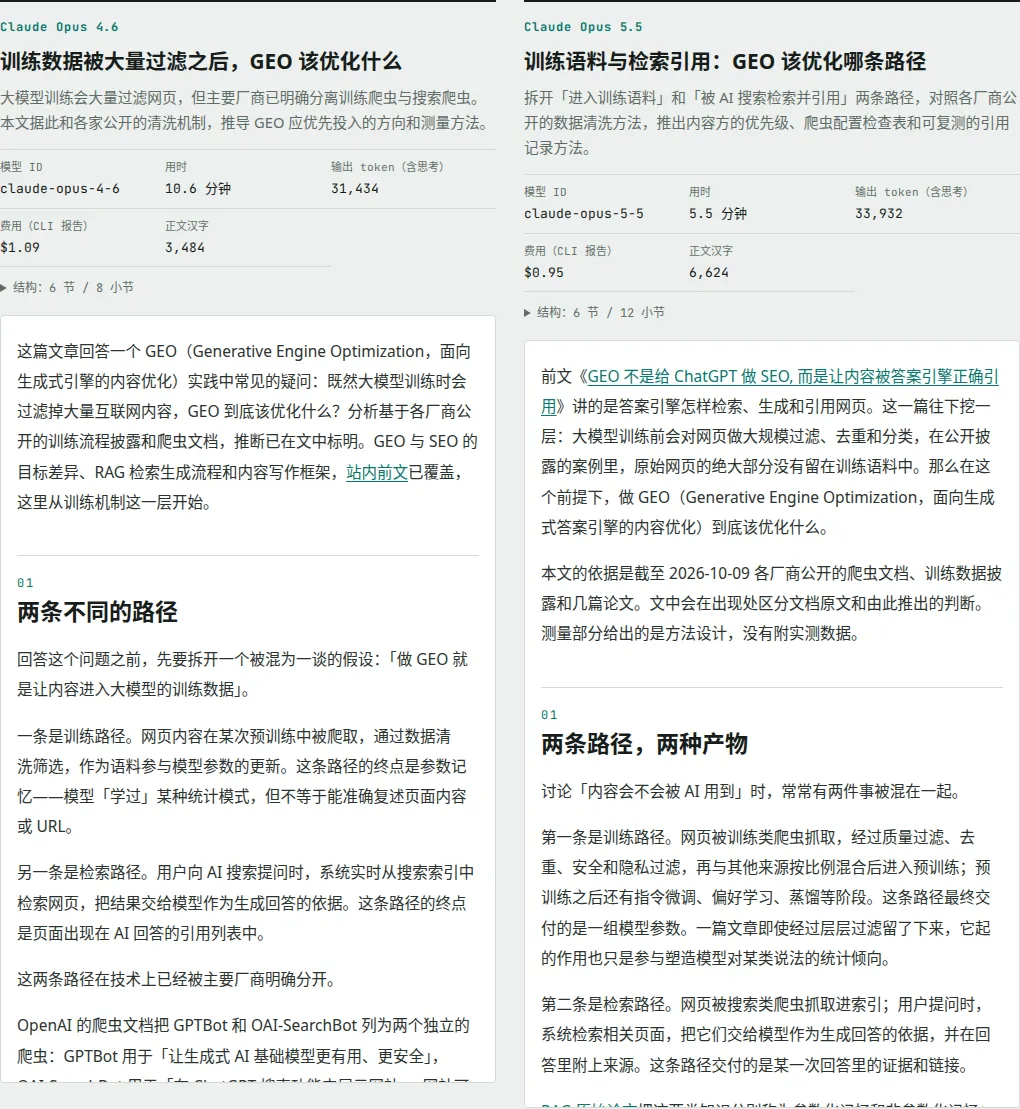
Opus 5.5 那篇后来按下文「AI 的分析」里的核对清单修订,发布为《训练语料与检索引用:GEO 该优化哪条路径》。底稿由做修订的 Claude Opus 5.5 选定,理由是篇幅达到任务书要求、核对出的问题更少;它同时是被比较的一方。对照页上的两篇原稿保持原样。
原始资料
- 任务书:本站「写作调性」规范的当时版本、6 条内容红线、与站内已发布 GEO 文章的分工、19 条事实包、frontmatter 骨架和标题描述长度限制,建议篇幅 4,500–7,000 个汉字。事实包里每条都附原始链接,任务书规定外部事实只能用这 19 条。对照阅读页顶部可以展开全文。
- 参考报告:《GEO 优化与大模型训练、数据清洗机制:深度调研报告》,docx 文件元数据标注由 ChatGPT Deep Research 生成,底层模型没有记录。任务书把它当背景材料,事实以事实包为准;报告本身没有经过本站核验。
- 两次调用的原始返回:Claude Code CLI 输出的 JSON,
result字段是稿件全文,modelUsage字段是实际调用的模型,另有用时、token 和费用。 - 资料包里还有系统提示、把报告转成 Markdown 的脚本,以及每个文件的 SHA-256。
过程
两次调用的系统提示和用户消息完全相同。用户消息是任务书加上报告转成的 Markdown,共 77,443 字节,SHA-256 以 7190494a 开头。系统提示很短:身份是中文技术写作者,没有工具、不能联网、只用用户消息里的材料,最终回复就是完整的 Markdown 文件。
调用用的是 Claude Code CLI 的非交互模式,--effort high,关掉所有工具和 MCP,两次并行,完整命令在资料包的 README 里。实际模型以返回 JSON 的 modelUsage 为准,分别是 claude-opus-4-6 和 claude-opus-5-5,不是让模型自报。
除系统提示和用户消息外,CLI 还会自动往上下文里加入本机的用户级说明文件(一份通用的代理工作规范)、一条账号邮箱提醒和运行环境信息(含模型名和日期)。两次调用相同,所以输入相同这一点不受影响;但这部分不在资料包里,用资料包重跑,输入不会完全一样。原实验记录漏了这一点,2026-10-10 整理发布时用同样参数的探针调用才确认。
任务书和事实包由 Claude Opus 5.5 起草。事实包逐条打开原始页面核验,OpenAI 的两个页面拒绝自动抓取,只用搜索结果摘录交叉确认。
生成之后没有任何后处理。对照阅读页直接渲染 JSON 的 result 字段,构建时逐字比对页面用的文件和原始返回,不一致就构建失败。
结果
| Claude Opus 4.6 | Claude Opus 5.5 | |
|---|---|---|
| 标题 | 训练数据被大量过滤之后,GEO 该优化什么 | 训练语料与检索引用:GEO 该优化哪条路径 |
| 正文汉字(不含代码块) | 3,484 | 6,624 |
| 二级 / 三级小节 | 6 / 8 | 6 / 12 |
| 表格 | 2 | 5 |
| 正文链接 / 参考来源 | 34 / 17 | 23 / 21 |
| 加粗 | 2 | 2 |
| 「推断」出现次数 | 4 | 14 |
| 用时 | 10.6 分钟 | 5.5 分钟 |
| 输出 token(含思考) | 31,434 | 33,932 |
| 其中思考 token | 24,456 | 20,749 |
| 费用(CLI 按标价报告) | $1.09 | $0.95 |
两篇用到的外部链接全部来自事实包,都没有写一级标题,中文都用了全角标点。
AI 的分析
这一节的核对和评语由 Claude Opus 5.5 在 2026-10-09 写成,发布时只把引用位置从行号换成了原句。Opus 5.5 同时是任务书的起草者和被比较的一方,可能偏向自己的写法。建议先读两篇原文,再看这里。
事实与红线核对:Opus 4.6
- 「模型参数不是一个简单的网页数据库副本」被放在引号里,作为 OpenAI 原话并配了链接。事实包里没有这句,它来自参考报告的中文概括。OpenAI 页面的意思与此接近,但引号里不是原文。
- 「Google 的指南提到生成式搜索会呈现整个网络中关于产品的内容」不在事实包里。复核 Google 页面,确有此意("can show what's being said about products and services across the web … blogs, videos, and forum discussions"),事实成立,只是违反了只用事实包的规则。
- 由 45TB 和 570GB 算出「约 98.7% 的内容被丢弃」。论文写的是 45TB 压缩纯文本,570GB 没有说明是否压缩,两个数口径未必相同,不能这样算百分比。直接给出两个数更稳。
- 「去重是所有公开过流程的厂商都在做的事」以偏概全,任务书要求不把个别厂商的做法推广为全部。
- 「此外,合成数据在训练中的比重也在增加」是没有来源的趋势判断。
- Google 说它的 AI 功能没有额外的技术要求,文章把这句推广成「就是 AI 搜索对技术层面的全部要求」,确定性被升级了。
- 配对测试的方法在正文出现处没有说明未经验证,只在文末「边界」里交代,违反内容红线第 3 条。
- 正文 3,484 字,低于任务书建议的 4,500–7,000 字。
事实与红线核对:Opus 5.5
- 「按论文给出的这两个数字计算,相差约 80 倍」有同样的口径问题,但写明了是按两个数字计算。可以再补一句两数口径不同。
- 「在公开材料里,训练路径上没有『单页申诉』或『重新抓取后更新』之类的机制」是根据没看到做出的否定判断,没有核实。更稳的写法是「本文查到的公开材料里未见……」。
- 「在训练侧会落入『文本过短』的那一类」把 PanGu-α 的一条清洗规则推广到所有训练流程,应该和同一句的后半句一样标为推断。
- 「边界」小节写进了这次核验的过程(OpenAI 页面拒绝自动抓取、经搜索摘录确认)。内容属实,放在正文里是否合适可以讨论。
- 「推断」出现 14 次。逐处标注满足了内容红线第 3 条,但读起来偏防守,和写作规范里「限制说一次」有张力。
两篇都没有写作者的经历、客户或数字。Opus 5.5 稿里的虚构内容(写法对比和记录表)都在同一块里标了「虚构示例」,Opus 4.6 稿没有虚构示例。
文笔观察
这部分是主观判断。
Opus 4.6 更像一篇博客。段落短,按两条路径、清洗有多重、对内容方意味着什么、优先级、测量的顺序线性推进,节与节之间有过渡句,读起来顺。句子干净,例如「AI 面临的不是『找不到你』而是『不知道该信哪个你』」。代价是自己的推理增量少:事实一致性、第三方验证、指标表基本是参考报告的压缩版,篇幅也没有达到要求。
Opus 5.5 更像一篇分析文章。它按哪类网页会在哪一步出局来组织清洗环节,而不是按厂商罗列,并把训练侧和检索侧对应起来,例如「门槛与检索路径重合」一条,以及把「非大路货」和去重放在一起讨论。从 GPT-3 去污染 bug 推出训练路径没有单页更新的机制,这是参考报告里没有的。定义句也更利落,例如「训练路径决定模型平时『知道什么』,检索路径决定某一次回答『拿谁当证据、给谁链接』」。代价是长而密:五张表加多处列表,有些段落读起来像报告,反复出现的推断标注打断节奏。
在这份任务书下,Opus 5.5 在遵守约束、核对口径和独立推理上明显更强;如果文笔主要指可读性和节奏,Opus 4.6 并不差,甚至更轻快。
这次对比说明不了什么
- 每个模型只跑了一次。同一模型重跑,结构和长度都可能明显不同。
- 任务书用本站的口吻规范、内容红线和事实包把发挥空间压得很窄,测的是在本站规范下写这一篇文章,不是一般意义上的文笔。
- 任务书由 Opus 5.5 起草,核对和评语也由 Opus 5.5 完成。
- 两次调用都带着 CLI 自动加入的同一段额外上下文,用资料包重跑不会完全复现。
- 用时和费用是单次调用的数值,不能当作两个模型的稳定差异。
核对里出现的几类问题,包括转述加引号、口径不同的两个数相除、由没查到推出不存在、逐句挂「推断」,已经补进本站给人和模型共用的写作规范。
写作说明:Claude Opus 5.5 撰写本文;两篇对比稿分别出自 Claude Opus 4.6 与 5.5;作者决定公开。
评论
评论由 GitHub Discussions 提供。登录 GitHub 后即可评论。 前往对应 Discussion